L'adozione del cloud non equivale alla maturità cloud
Circa metà delle imprese dell'UE acquista servizi cloud a pagamento. Solo una su sette usa il cloud per sviluppare, testare o rilasciare applicazioni — e quattro domande dicono molto di più su come lo state gestendo di qualsiasi elenco di strumenti.
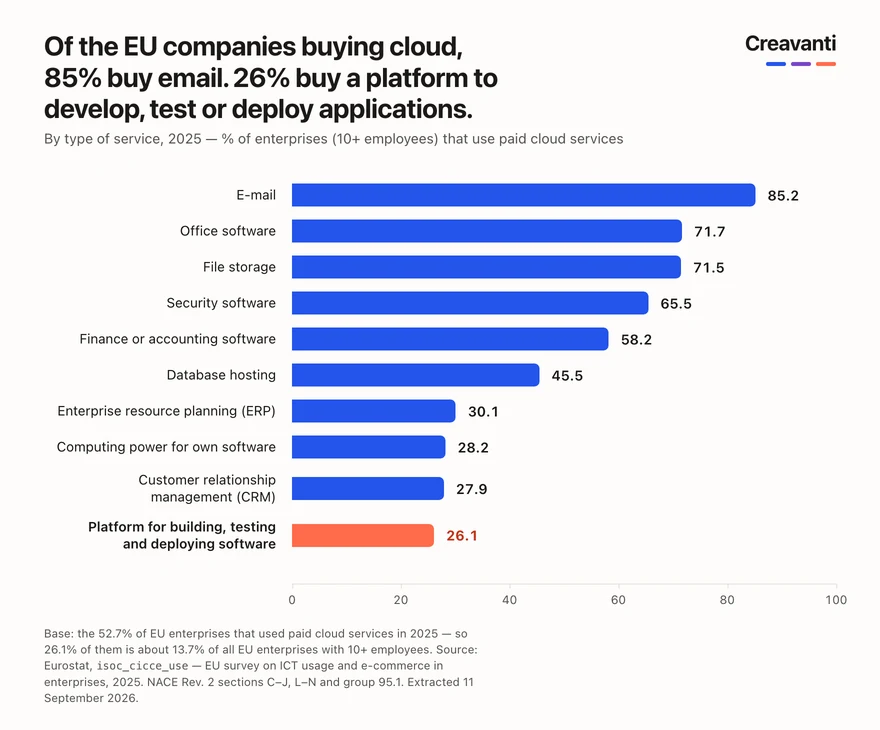
Circa metà delle imprese dell’UE acquista oggi servizi cloud a pagamento. Fra queste, l’85,2% usa il cloud per la posta elettronica — mentre solo il 26,1% usa piattaforme cloud per sviluppare, testare o rilasciare applicazioni. Quel secondo gruppo rappresenta circa il 14% di tutte le imprese coperte dall’indagine: più o meno una su sette.
isoc_cicce_use, 2025.L’adozione del cloud varia enormemente in Europa, dal 79,2% delle imprese in Finlandia al 17,8% in Bulgaria. L’Italia è al 75,6%, terza nell’Unione europea.
Questo articolo è rivolto soprattutto a quell’impresa su sette che già sviluppa o gestisce software nel cloud. Se siete in una fase precedente del percorso, le stesse domande restano valide — semplicemente si presentano su una scala più semplice.
Spostare l’infrastruttura nel cloud cambia il luogo in cui gira il software. Non rende automaticamente il software più facile da modificare, l’infrastruttura più facile da capire, la bolletta più semplice da spiegare o la produzione più facile da gestire.
È questa la distinzione che intendiamo quando parliamo di maturità cloud. Conta meno quali servizi cloud utilizzate e molto di più se la vostra organizzazione sa rispondere a quattro domande pratiche.
1. Una piccola modifica può arrivare in produzione in modo sicuro e prevedibile?
Un’azienda che analizziamo può già avere quello che sembra un processo di delivery moderno. Il codice passa dalla CI. I test vengono eseguiti automaticamente. Il deployment è automatizzato.
Eppure i rilasci continuano a essere complicati.
Seguite una modifica reale dalla macchina di uno sviluppatore fino alla produzione e potreste trovare una situazione molto diversa da quella rappresentata nel diagramma di architettura: un valore di configurazione copiato a mano; un’approvazione che aggiunge regolarmente mezza giornata; test verdi che non coprono l’integrazione in cui si verificano davvero i problemi; un deployment che un solo ingegnere conosce abbastanza bene da poter recuperare mentre il resto del team no; oppure una procedura di rollback che nessuno vorrebbe provare per la prima volta durante un incidente reale.
La pipeline c’è. La capacità di delivery intorno alla pipeline è incompleta.
Come affrontiamo il problema
Quando analizziamo il delivery, non partiamo chiedendo quale strumento di CI/CD venga utilizzato. Seguiamo una modifica reale dall’inizio alla fine. Dove rimane in attesa? Cosa avviene manualmente? Cosa potrebbe rompersi senza che un test se ne accorga? Cosa cambia fra un ambiente e l’altro? Cosa succede quando il deployment è sbagliato?
Poi interveniamo sul vincolo reale. Può significare migliorare i test di integrazione. Eliminare un’approvazione. Automatizzare la configurazione. Rendere il rollback prevedibile.
L’obiettivo non è “più CI/CD”. È:
Una piccola modifica può arrivare in produzione senza drammi e il team capisce rapidamente se qualcosa è andato storto.
Cosa potete verificare da soli
Scegliete una modifica ordinaria rilasciata nell’ultimo mese. Misurate quanto tempo ha trascorso in attesa rispetto al tempo in cui qualcuno ci ha effettivamente lavorato. Poi annotate ogni punto in cui una persona ha dovuto ricordarsi qualcosa, copiare, approvare o verificare manualmente.
Spesso questo dice molto di più sulla vostra reale capacità di delivery rispetto al diagramma della pipeline.
2. Un altro ingegnere saprebbe ricreare e spiegare l’ambiente?
Un altro tipo di analisi parte spesso da un’infrastruttura che funziona perfettamente — finché qualcuno non chiede perché sia fatta proprio così.
Prima viene creato un ambiente di sviluppo. Poi arriva la produzione. Qualcuno modifica direttamente un’autorizzazione dalla console. Una risorsa temporanea diventa permanente. Una credenziale viene creata per un’esigenza una tantum. Due anni dopo, nessuno è abbastanza sicuro da eliminare qualcosa.
Non significa necessariamente che ci sia qualcosa di rotto. Il problema è che l’infrastruttura ha accumulato più storia che spiegazioni.
Come affrontiamo il problema
Prima di parlare di Infrastructure as Code, poniamo domande più semplici. Possiamo ricostruire questo ambiente se scompare? Perché esiste ogni risorsa importante? Chi ne è responsabile? Possiamo concedere e revocare gli accessi in modo controllato? Sviluppo e produzione sono diversi perché devono esserlo — o perché nel tempo si sono allontanati? Un altro ingegnere riuscirebbe a capire l’ambiente senza dover cercare chi lo ha costruito?
Quando queste risposte sono chiare, Infrastructure as Code può entrare nella soluzione. Ma Terraform, CDK o qualsiasi altro strumento non sono il risultato. Il risultato è la riproducibilità.
Un ambiente più sano è un ambiente che il team può capire, revisionare, ricreare e modificare senza dipendere dalla memoria di una persona.
Cosa potete verificare da soli
Scegliete un ambiente importante e immaginate che domani scompaia. Il team riuscirebbe a ricrearlo usando ciò che oggi è documentato e versionato?
Se la risposta è “probabilmente sì, ma dovremmo chiedere a X”, avete trovato qualcosa che merita di essere approfondito.
3. Sapete spiegare quanto costa il cloud — e perché?
A volte iniziamo un’analisi perché qualcuno ha notato una cosa molto semplice: la bolletta cloud continua a crescere.
Non significa necessariamente che esista un problema. Se utilizzo e ricavi aumentano, è del tutto ragionevole che cresca anche la spesa infrastrutturale. Il segnale d’allarme è quando nessuno sa spiegare cosa sia cambiato.
Un’analisi può far emergere ambienti non di produzione lasciati attivi in modo permanente, risorse sovradimensionate, storage dimenticato, servizi senza un responsabile chiaro oppure diversi team che pagano separatamente per varianti della stessa capacità. Niente di tutto questo deve essere spettacolare. Gli sprechi nel cloud sono spesso noiosi: si accumulano una decisione apparentemente ragionevole alla volta.
Come affrontiamo il problema
Non partiamo dagli sconti. Prima creiamo visibilità. Quali servizi generano la spesa? Cosa è cambiato da un mese all’altro? Quali costi crescono con l’utilizzo da parte dei clienti e quali no? Chi è responsabile delle risorse? Cosa può essere spento, ridimensionato o riprogettato?
Solo a quel punto l’ottimizzazione diventa significativa. A volte la risposta è automatizzare il ciclo di vita. A volte fare rightsizing. A volte cambiare l’architettura. A volte basta rendere visibile agli ingegneri l’impatto economico di una decisione nel momento in cui viene presa, anziché tre mesi dopo. È qui che le pratiche FinOps possono aiutare.
Il risultato utile non è necessariamente una bolletta più bassa. È poter dire:
Sappiamo per cosa stiamo pagando, perché il costo è cambiato, chi ne è responsabile e se quella spesa ha senso rispetto al valore che sostiene.
Cosa potete verificare da soli
Prendete le cinque voci più costose della bolletta cloud dello scorso mese. Per ciascuna: chi ne è responsabile? Quale workload di business supporta? Perché è costata quella cifra? Cosa succederebbe se l’utilizzo raddoppiasse?
Se per rispondere serve un piccolo progetto di ricerca, partite da lì prima di cercare di negoziare un cloud più economico.
4. Il team si accorgerà del problema prima del cliente?
Questa è la domanda più facile da rendere astratta, quindi usiamo un test molto concreto.
Immaginate che uno dei percorsi più importanti per il cliente diventi lento o inizi a fallire. Qual è il primo alert che scatta? È un segnale che dice al team qualcosa di utile e su cui può agire — oppure il primo segnale davvero significativo è esattamente il problema per cui un cliente avrebbe chiamato?
Abbiamo visto sistemi con dashboard, log e moltissimi alert in cui questa distinzione risultava sorprendentemente scomoda. Le metriche dell’infrastruttura venivano raccolte. I segnali che rappresentavano un vero problema per il cliente no. Il risultato era molta telemetria e pochissimo preavviso utile.
Come affrontiamo il problema
Partiamo dal guasto e lavoriamo a ritroso. Cosa sperimenterebbe il cliente? Cosa dovrebbe vedere il team prima che accada? Quale segnale indica davvero che il servizio ha un problema? Chi interviene? Di quali informazioni ha bisogno subito?
Da qui, la soluzione può essere una telemetria applicativa migliore, un alert diverso, un runbook, recovery automatico o ownership più chiara. Spesso non si tratta di aggiungere monitoring, ma di eliminare il rumore e misurare ciò che conta davvero.
L’obiettivo è semplice:
Quando qualcosa di importante degrada, il team vede il problema, capisce abbastanza da poter intervenire e sa chi è responsabile della risposta.
Cosa potete verificare da soli
Prendete l’ultimo incidente significativo in produzione. Che cosa vi ha fatto capire per primo che c’era un problema? Poi chiedetevi: quale segnale avrebbe potuto dircelo prima?
Quella distanza è spesso più utile del numero di dashboard.
Quattro domande, lo stesso problema di fondo
Le situazioni sembrano diverse: rilasci lenti; infrastruttura che nessuno vuole toccare; spesa cloud che nessuno sa spiegare; clienti che scoprono i problemi prima del team.
Ma hanno qualcosa in comune. L’organizzazione utilizza tecnologia cloud senza avere ancora tutte le capacità operative necessarie per usarla con sicurezza.
Per questo non valutiamo gli ambienti cloud contando gli strumenti. Cerchiamo prove che l’organizzazione sappia modificare il software in modo prevedibile, capire e ricreare l’infrastruttura, collegare i costi a ownership e utilizzo e rilevare e gestire efficacemente i problemi operativi.
Questa è una definizione molto più utile di maturità cloud rispetto al semplice fatto di avere spostato workload su AWS, Azure, GCP o un’altra piattaforma.
Per questo non partiamo da “vi serve DevOps”
DevOps può portare a CI/CD, Infrastructure as Code, observability, automazione della sicurezza, pratiche FinOps o platform engineering. Sono possibili interventi. Non sono la diagnosi.
Partiamo dal vincolo. Qualcosa richiede troppo tempo. Qualcosa è difficile da ricreare. Qualcosa costa più di quanto qualcuno sappia spiegare. Qualcosa si rompe senza che le persone giuste lo sappiano abbastanza presto.
Poi risaliamo alla causa e scegliamo l’intervento più semplice che migliori concretamente il modo in cui il sistema viene rilasciato o gestito. A volte è automazione. A volte architettura. A volte ownership. A volte significa eliminare un passaggio dal processo anziché aggiungere un altro strumento. È così che affrontiamo il nostro lavoro su DevOps e cloud.
L’adozione del cloud vi dice che la tecnologia si è spostata. La maturità cloud vi dice se l’organizzazione sa modificarla in sicurezza, capire cosa sta girando, spiegare quanto costa e reagire quando qualcosa va storto.
Se alcune delle domande precedenti hanno prodotto risposte scomode, sono anche un buon punto di partenza per migliorare — sia che decidiate di farlo internamente, sia che cerchiate supporto esterno.
E se volete un secondo punto di vista, la nostra valutazione gratuita di 20 minuti parte dalle stesse domande. Se DevOps fa parte della risposta, ve lo diremo. Se non lo fa, ve lo diremo altrettanto chiaramente.
Fonte: Eurostat, indagine UE 2025 sull’uso delle TIC e sul commercio
elettronico nelle imprese, dataset
isoc_cicce_use.
L’indagine copre le imprese con almeno 10 persone occupate o lavoratori autonomi
nei settori considerati.