Adopția cloud nu înseamnă maturitate cloud
Aproximativ jumătate dintre companiile din UE cumpără servicii cloud plătite. Doar una din șapte folosește cloudul pentru a dezvolta, testa sau livra aplicații — iar patru întrebări spun mai multe despre cât de bine îl folosiți decât orice listă de instrumente.
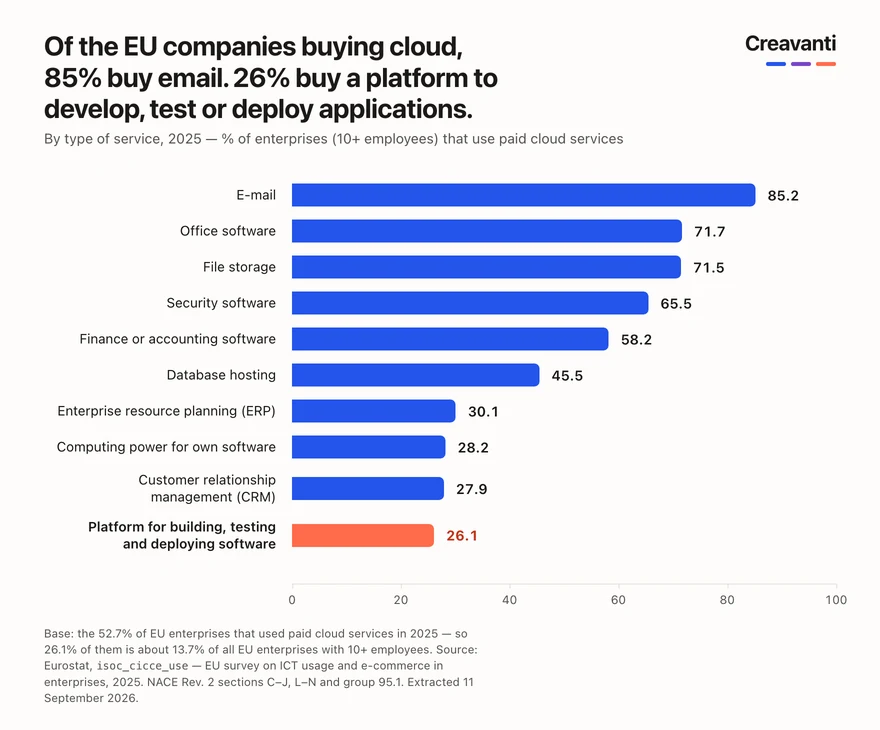
Aproximativ jumătate dintre companiile din UE cumpără astăzi servicii cloud plătite. Dintre acestea, 85,2% folosesc cloudul pentru e-mail — în timp ce doar 26,1% folosesc platforme cloud pentru a dezvolta, testa sau livra aplicații. Al doilea grup reprezintă aproximativ 14% dintre toate companiile incluse în anchetă: cam una din șapte.
isoc_cicce_use, 2025.Adopția cloud variază foarte mult în Europa, de la 79,2% dintre companii în Finlanda la 17,8% în Bulgaria. România se află la 24,9%, aproape de capătul de jos.
Articolul acesta se adresează în primul rând acelei companii din șapte care deja dezvoltă sau rulează software în cloud. Dacă sunteți într-o etapă mai timpurie, aceleași întrebări rămân valabile — doar că apar la o scară mai simplă.
Mutarea infrastructurii în cloud schimbă locul în care rulează software-ul. Nu îl face automat mai ușor de modificat, infrastructura mai ușor de înțeles, factura mai ușor de explicat sau producția mai ușor de operat.
Asta este diferența la care ne referim când vorbim despre maturitate cloud. Contează mai puțin ce servicii cloud folosiți și mai mult dacă organizația poate răspunde la patru întrebări practice.
1. Poate o modificare mică să ajungă în producție în siguranță și în mod previzibil?
O companie pe care o evaluăm poate avea deja ceea ce pare un proces modern de livrare. Codul trece prin CI. Testele rulează automat. Deployment-ul este automatizat.
Și totuși, lansările continuă să fie dificile.
Urmăriți o modificare reală de pe calculatorul unui dezvoltator până în producție și puteți găsi o realitate foarte diferită de cea din diagrama de arhitectură: o valoare de configurare copiată manual; o aprobare care adaugă în mod constant jumătate de zi; teste verzi care nu acoperă integrarea în care apar de fapt problemele; un deployment pe care un singur inginer știe suficient de bine să îl recupereze, iar restul echipei nu; sau o procedură de rollback pe care nimeni nu vrea să o testeze pentru prima dată în timpul unui incident real.
Pipeline-ul există. Capacitatea de livrare din jurul lui este incompletă.
Cum abordăm noi problema
Când analizăm procesul de livrare, nu începem prin a întreba ce instrument de CI/CD este folosit. Urmărim o modificare reală de la un capăt la celălalt. Unde așteaptă? Ce se întâmplă manual? Ce ar putea eșua fără ca testele să observe? Ce diferă între medii? Ce se întâmplă când deployment-ul este greșit?
Apoi lucrăm asupra constrângerii reale. Poate fi nevoie de teste de integrare mai bune. Poate fi eliminată o aprobare. Poate fi automatizată configurația sau făcut rollback-ul predictibil.
Obiectivul nu este „mai mult CI/CD”. Este:
O modificare mică poate ajunge în producție fără dramă, iar echipa află rapid dacă ceva a mers prost.
Ce puteți verifica singuri
Alegeți o modificare obișnuită livrată în ultima lună. Măsurați cât timp a petrecut așteptând și cât timp s-a lucrat efectiv la ea. Apoi notați fiecare punct în care cineva a trebuit să își amintească ceva, să copieze, să aprobe sau să verifice manual.
De cele mai multe ori, asta spune mai multe despre capacitatea reală de livrare decât diagrama pipeline-ului.
2. Ar putea un alt inginer să recreeze și să explice mediul?
Un alt tip de evaluare începe deseori cu o infrastructură care funcționează foarte bine — până când cineva întreabă de ce arată așa.
Mai întâi a fost creat mediul de dezvoltare. Apoi producția. Cineva a schimbat o permisiune direct în consolă. O resursă temporară a devenit permanentă. O credențială a fost creată pentru o nevoie punctuală. Doi ani mai târziu, nimeni nu este suficient de sigur încât să elimine ceva.
Nu înseamnă neapărat că există o problemă funcțională. Problema este că infrastructura a acumulat mai multă istorie decât explicație.
Cum abordăm noi problema
Înainte să vorbim despre Infrastructure as Code, punem întrebări mai simple. Putem reconstrui acest mediu dacă dispare? De ce există fiecare resursă importantă? Cine răspunde de ea? Pot fi acordate și retrase accesurile în mod controlat? Mediile de dezvoltare și producție sunt diferite pentru că trebuie să fie — sau pentru că au derivat în timp? Ar putea alt inginer să înțeleagă mediul fără să caute persoana care l-a construit?
După ce răspunsurile sunt clare, Infrastructure as Code poate face parte din soluție. Dar Terraform, CDK sau orice alt instrument nu reprezintă rezultatul. Reproductibilitatea este rezultatul.
Un mediu mai sănătos este unul pe care echipa îl poate înțelege, verifica, recrea și modifica fără să depindă de memoria unei persoane.
Ce puteți verifica singuri
Alegeți un mediu important și imaginați-vă că mâine dispare. Ar putea echipa să îl recreeze din ceea ce este documentat și versionat astăzi?
Dacă răspunsul este „probabil, dar ar trebui să îl întrebăm pe X”, ați găsit ceva care merită investigat.
3. Puteți explica ce costă cloudul — și de ce?
Uneori intrăm într-o evaluare pentru că cineva a observat un lucru simplu: factura cloud continuă să crească.
Asta nu înseamnă neapărat că există o problemă. Dacă utilizarea și veniturile cresc, este cât se poate de rezonabil ca și cheltuiala cu infrastructura să crească. Semnalul de alarmă apare când nimeni nu poate explica ce s-a schimbat.
O analiză poate scoate la iveală medii non-production care rulează permanent, resurse supradimensionate, storage uitat, servicii fără un responsabil clar sau mai multe echipe care plătesc separat pentru variații ale aceleiași capabilități. Nimic din toate acestea nu trebuie să fie spectaculos. Risipa în cloud este adesea banală: se acumulează câte o decizie aparent rezonabilă.
Cum abordăm noi problema
Nu începem cu reducerile. Mai întâi obținem vizibilitate. Ce servicii generează costurile? Ce s-a schimbat de la o lună la alta? Ce costuri cresc odată cu utilizarea clienților și care nu? Cine răspunde de resurse? Ce poate fi oprit, redimensionat sau reproiectat?
Abia apoi optimizarea începe să aibă sens. Uneori răspunsul este automatizarea ciclului de viață. Alteori rightsizing. Alteori arhitectură. Uneori este suficient să facem costul vizibil pentru ingineri în momentul în care iau decizia, nu trei luni mai târziu. Aici pot ajuta practicile de FinOps.
Rezultatul util nu este neapărat o factură mai mică. Este să puteți spune:
Știm pentru ce plătim, de ce s-a schimbat costul, cine răspunde de el și dacă are sens în raport cu valoarea pe care o susține.
Ce puteți verifica singuri
Luați cele mai mari cinci poziții din factura cloud de luna trecută. Pentru fiecare: cine răspunde de ea? Ce workload de business susține? De ce a costat atât? Ce s-ar întâmpla dacă utilizarea s-ar dubla?
Dacă răspunsurile cer un proiect de investigație, începeți de acolo înainte să încercați să negociați un cloud mai ieftin.
4. Va observa echipa problema înaintea clientului?
Aici lucrurile pot deveni ușor abstracte, așa că merită un test foarte concret.
Imaginați-vă că unul dintre fluxurile importante pentru client devine lent sau începe să eșueze. Care este primul alert care se declanșează? Este un alert care îi spune echipei ceva pe baza căruia poate acționa — sau primul semnal cu adevărat relevant este exact problema pentru care ar fi sunat un client?
Am văzut sisteme cu dashboard-uri, loguri și multe alerte în care răspunsul la întrebarea asta era surprinzător de inconfortabil. Metricile de infrastructură existau. Semnalele care reprezentau o problemă reală pentru client nu existau. Rezultatul: multă telemetrie și foarte puțin avertisment util.
Cum abordăm noi problema
Pornim invers, de la scenariul de eșec. Ce ar experimenta clientul? Ce ar trebui să vadă echipa înainte să se întâmple asta? Ce semnal spune de fapt că serviciul are o problemă? Cine răspunde? Ce informații îi trebuie imediat?
De aici, soluția poate fi telemetrie mai bună la nivel de aplicație, alt alert, un runbook, recovery automat sau ownership mai clar. De multe ori nu este vorba despre mai mult monitoring, ci despre mai puțin zgomot și măsurarea lucrurilor potrivite.
Obiectivul este simplu:
Când ceva important se degradează, echipa vede problema, înțelege suficient ca să acționeze și știe cine răspunde de intervenție.
Ce puteți verifica singuri
Luați ultimul incident semnificativ din producție. Ce v-a spus prima dată că există o problemă? Apoi întrebați: ce semnal ne-ar fi putut spune asta mai devreme?
Diferența dintre cele două spune, de obicei, mai mult decât numărul de dashboard-uri.
Patru întrebări, aceeași problemă de fond
Situațiile par diferite: livrări lente; infrastructură pe care nimeni nu vrea să o atingă; costuri cloud pe care nimeni nu le poate explica; clienți care descoperă problemele primii.
Dar au ceva în comun. Organizația folosește tehnologie cloud fără să aibă încă toate capabilitățile operaționale necesare pentru a o folosi cu încredere.
De aceea nu evaluăm mediile cloud numărând instrumentele. Căutăm dovezi că organizația poate modifica software-ul în mod previzibil, înțelege și reproduce infrastructura, lega costurile de ownership și utilizare și detecta și trata eficient problemele operaționale.
Este o definiție mult mai utilă a maturității cloud decât simplul fapt că workload-urile au fost mutate pe AWS, Azure, GCP sau altă platformă.
De aceea nu pornim de la „aveți nevoie de DevOps”
DevOps poate duce la CI/CD, Infrastructure as Code, observability, automatizare de securitate, practici FinOps sau platform engineering. Acestea sunt posibile intervenții. Nu sunt diagnosticul.
Pornim de la constrângere. Ceva durează prea mult. Ceva este greu de reprodus. Ceva costă mai mult decât poate explica cineva. Ceva se strică fără ca oamenii potriviți să afle suficient de repede.
Apoi urmărim cauza și alegem cea mai simplă intervenție care îmbunătățește în mod real felul în care sistemul este livrat sau operat. Uneori este automatizare. Uneori arhitectură. Uneori ownership. Uneori eliminăm un pas din proces în loc să adăugăm încă un instrument. Așa arată munca noastră de DevOps și cloud.
Adopția cloud vă spune că tehnologia s-a mutat. Maturitatea cloud vă spune dacă organizația o poate modifica în siguranță, poate înțelege ce rulează, poate explica ce costă și poate reacționa atunci când ceva nu merge bine.
Dacă unele dintre întrebările de mai sus au produs răspunsuri inconfortabile, sunt și un punct bun de plecare pentru îmbunătățire — fie că lucrați intern, fie că apelați la ajutor extern.
Iar dacă vreți încă o perspectivă, evaluarea noastră gratuită de 20 de minute pornește de la aceleași întrebări. Dacă DevOps face parte din răspuns, o să vă spunem. Dacă nu, o să vă spunem și asta.
Sursă: Eurostat, ancheta UE 2025 privind utilizarea TIC și comerțul electronic
în întreprinderi, setul de date
isoc_cicce_use.
Ancheta acoperă întreprinderile cu cel puțin 10 persoane angajate sau lucrători
independenți în sectoarele incluse.